Jev von TypeSafe AI: Was das System-One-Modell wirklich kann
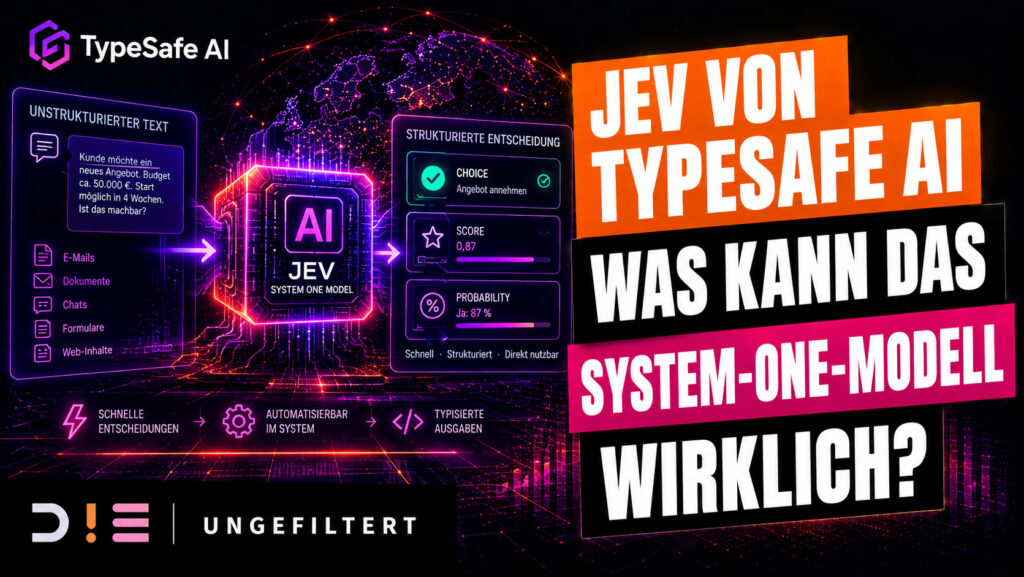
Kurz gesagt: Das Start-up TypeSafe AI hat am 15. September 2026 das Modell Jev veröffentlicht, zunächst im Early Access über eine Warteliste. Jev ist kein Sprachmodell. Es schreibt keine Texte, sondern gibt Entscheidungen zurück: typisierte Werte in einem Format, das du vorher festlegst, jeweils mit einer Wahrscheinlichkeit, wie sicher sich das Modell ist. Weil es nicht Wort für Wort schreibt, sondern alles in einer Abfrage ausgibt, liegt die Antwortzeit laut Anbieter bei 70 bis 500 Millisekunden. Der Input kostet 0,042 Dollar je Million Token, der Output ist kostenlos. TypeSafe nennt die Modellklasse „System One Models“. Hinter der Firma steht Diogo Almeida, früher OpenAI und Mitautor des InstructGPT-Papers, finanziert mit 40 Millionen Dollar.
Stand: 21. September 2026. Alle Leistungsangaben stammen aus Messungen des Anbieters, unabhängige Vergleiche liegen noch nicht vor.
Seit zwei Jahren dreht sich jede KI-Diskussion um dieselbe Frage: Welches Modell schreibt besser? Hier kommt eines, das gar nicht schreibt. Und ausgerechnet das macht es für Unternehmen interessanter als der nächste Punkt im Benchmark.
Was Jev anders macht
Ein normales Sprachmodell erzeugt seine Antwort Wort für Wort. Jedes Wort hängt vom vorherigen ab, deshalb dauert eine lange Antwort länger als eine kurze. Das ist der Grund, warum du beim Chatten zusiehst, wie der Text entsteht.
Jev arbeitet anders. Du gibst ihm unstrukturierten Input und ein Schema, also die Form der Antwort, die du haben willst. Zurück kommt kein Fließtext, sondern ein ausgefülltes Formular: Feldwerte im vorgegebenen Format, dazu für jede Angabe eine Wahrscheinlichkeit. Alles in einer einzigen Abfrage, parallel statt nacheinander.
Der Name der Modellklasse spielt auf Daniel Kahneman an. System 1 ist das schnelle, intuitive Entscheiden, System 2 das langsame, überlegte. Sprachmodelle, die sich durch eine Argumentation arbeiten, sind System 2. Jev ist der Reflex: Reiz rein, Entscheidung raus, ohne Begründung.
In der Demonstration des Anbieters beantwortet Jev eine Aufgabe in 0,114 Sekunden, für die ein aktuelles Sprachmodell 8,566 Sekunden braucht. The Register rechnet den Preisunterschied vor: 0,042 Dollar je Million Token gegenüber 2 Dollar für Input bei einem gängigen Spitzenmodell, bei kostenlosem Output. TypeSafe selbst nennt für eigene Workflow-Tests Faktoren von 193 bei der Geschwindigkeit und 444 beim Preis. Zur Demonstration lässt die Firma Jev außerdem Doom spielen, was hübsch ist, aber wenig über den Büroalltag sagt.
Damit die Wahrscheinlichkeiten etwas wert sind, hat TypeSafe ein eigenes Trainingsverfahren entwickelt, RLCD, Reinforcement Learning for Calibrated Decisions. Das Ziel: Wenn das Modell 80 Prozent Sicherheit angibt, soll es in etwa 80 von 100 Fällen richtig liegen. Genau das ist der Unterschied zwischen einer Zahl und einer brauchbaren Zahl.
Was das für dich heißt
Erstens: Viele deiner KI-Aufgaben sind gar keine Sprachaufgaben. Eingehende Anfragen einsortieren. Rechnungen einer Kostenstelle zuordnen. Bewerbungen vorsortieren. Reklamationen weiterleiten. Produktdaten aus einem PDF ziehen. In all diesen Fällen soll am Ende kein Text stehen, sondern eine Entscheidung. Trotzdem läuft das heute meist über ein Modell, das vor allem schreiben kann, und wird auch so abgerechnet.
Zweitens: Genau da versickert das Budget. Ein Drittel der Unternehmen, die KI einsetzen, sagt, sie sei teurer als kalkuliert, und der Kostentreiber sind nicht die Lizenzen, sondern der Token-Verbrauch in eigenen Anwendungen. Wenn eine Routine hunderttausendfach am Tag läuft, entscheidet nicht die Qualität des Modells über die Rechnung, sondern die Wahl der Werkzeugklasse. Ein Sprachmodell für eine Ja-Nein-Entscheidung ist ein Bagger für einen Blumentopf.
Drittens: Der Konfidenzwert ist die eigentliche Neuigkeit. Wenn zu jeder Entscheidung eine belastbare Wahrscheinlichkeit gehört, lässt sich zum ersten Mal sauber festlegen, wann ein Mensch draufschaut. Alles über 95 Prozent läuft durch, alles darunter landet auf einem Tisch. Das klingt unspektakulär, ist aber der Unterschied zwischen „ein Mensch prüft das“ als Behauptung und als eingestelltem Schwellenwert. Bei Entscheidungen über Menschen ist das mehr als ein technisches Detail.
Viertens: Heute kannst du damit noch nichts machen. Der Zugang läuft über eine Warteliste, unabhängige Vergleiche fehlen, und niemand weiß, wie sich das Modell in einem echten Betrieb schlägt. Die Handlung für diese Woche ist deshalb keine Anschaffung, sondern eine Frage an deinen Dienstleister oder deine IT: Welche unserer KI-Aufgaben sind eigentlich Entscheidungen und keine Texte, und was kosten die gerade? Diese Liste ist wertvoll, egal welches Werkzeug am Ende gewinnt.
Die D!E-Einordnung
Zuerst die Pflicht: Sämtliche Zahlen oben stammen vom Hersteller. Es gibt bislang keine unabhängige Messung, und ein Start-up, das gerade 40 Millionen Dollar eingesammelt hat, hat ein Interesse an großen Faktoren. Auch der Werbesatz, das Modell halluziniere nicht, hält der Prüfung nicht stand. Eine feste Antwortform verhindert, dass Unsinn wie ein Zitat aussieht. Sie verhindert nicht, dass die Antwort falsch ist. Sie macht den Fehler nur unauffälliger, und das ist nicht dasselbe wie sicherer.
Dann das Sympathische: Die Firma hat ihr Modell nach dem Jevons-Paradox benannt. Das besagt, dass der Verbrauch einer Ressource steigt, wenn ihre Nutzung effizienter wird. Übersetzt: Wer KI billiger macht, sorgt dafür, dass mehr davon verbraucht wird, nicht weniger. Dass ein Anbieter seinem Produkt diesen Namen gibt, ist entweder bemerkenswert ehrlich oder bemerkenswert selbstbewusst. Für dich heißt es: Erwarte keine kleinere Rechnung. Erwarte, dass du für dasselbe Geld sehr viel mehr automatisierst.
Und der Punkt, auf den es ankommt, unabhängig davon, ob sich ausgerechnet Jev durchsetzt: Die interessante Frage in Unternehmen lautet seit zwei Jahren „welches Modell nehmen wir“. Sie ist falsch gestellt. Die richtige lautet, welche Aufgabe hier eigentlich zu lösen ist. Die meisten KI-Projekte, die wir übernehmen, scheitern nicht an einem zu schwachen Modell. Sie scheitern daran, dass nie jemand aufgeschrieben hat, was am Ende herauskommen soll.
Weißt du, wofür deine KI-Kosten anfallen? Im kostenlosen Gespräch gehen wir deine KI-Anwendungen durch und trennen, was wirklich Sprache braucht und was nur eine Entscheidung ist. Meistens ist das die größte Position auf der Rechnung.
FAQ: Jev und System-One-Modelle
Was ist ein System-One-Modell?
Eine Klasse von KI-Modellen, die schnelle, strukturierte Entscheidungen zurückgibt statt Text. Das Modell bekommt unstrukturierten Input und ein vorher festgelegtes Ausgabeschema und liefert typisierte Werte mit Wahrscheinlichkeiten. Der Name spielt auf Daniel Kahnemans System 1 an, das schnelle, intuitive Denken, im Unterschied zum langsamen, argumentierenden System 2.
Ersetzt Jev ChatGPT oder Claude?
Nein, die Modelle lösen verschiedene Aufgaben. Jev kann keine Texte schreiben, nicht zusammenfassen und nicht argumentieren. Es eignet sich für Entscheidungen innerhalb von Software: einsortieren, weiterleiten, bewerten, Daten extrahieren. Für Inhalte, Beratung und Dialog bleiben Sprachmodelle zuständig. In der Praxis laufen beide nebeneinander, oft prüft ein System-One-Modell die Ein- oder Ausgaben eines Sprachmodells.
Kann ich Jev schon einsetzen?
Seit dem 15. September 2026 gibt es einen Early Access über eine Warteliste, der Zugang wird schrittweise freigeschaltet. Unabhängige Leistungsvergleiche liegen noch nicht vor, alle bisher genannten Werte stammen vom Anbieter. Für den produktiven Einsatz in einem Unternehmen ist es damit noch zu früh, für eine Bestandsaufnahme der eigenen KI-Aufgaben nicht.
Das Fazit, ungefiltert
Ob Jev das Rennen macht, weiß heute niemand. Die Modellklasse ist trotzdem die interessanteste Entwicklung dieses Herbstes, weil sie eine bequeme Annahme zerlegt: dass jede KI-Aufgabe ein Sprachmodell braucht.
Braucht sie nicht. Ein großer Teil dessen, was Unternehmen heute an KI bezahlen, sind Entscheidungen, die nie als Satz formuliert werden mussten. Dass jemand daraus eine eigene Produktkategorie macht, war überfällig.
Die Aufgabe für dich bleibt dieselbe wie bei jeder Modellmeldung der letzten drei Jahre: nicht das Werkzeug zuerst aussuchen, sondern die Aufgabe zuerst aufschreiben. Wer das getan hat, erkennt in fünf Minuten, ob so ein Modell etwas für ihn ist. Wer es nicht getan hat, diskutiert weiter über Benchmarks.
Geschrieben von Dag Achtzehn, Gründer von D!E mit Ausrufezeichen. KI-First-Marketing aus Montabaur für den DACH-Raum. Wir reden nicht über KI. Wir arbeiten damit.
Bereit, dein Marketing auf D!E-Niveau zu heben? Lass uns sprechen.
Sag Hallo →